什麼是 OLAP?OLTP?OCI Autonomous Database 說:我全都要
上一篇文章介紹了 OCI 的整體優勢和免費方案。這篇我們要深入聊一個我認為 OCI 最強的服務——Autonomous Database (ADB)。
如果你做過任何需要「存資料」的 Side Project,你一定經歷過這個靈魂拷問:資料到底要存在哪裡?
Excel?CSV?自己架 MySQL?用 Google Sheets 當資料庫?每個選擇都有各自的痛點,我全都踩過。最後讓我落腳的答案,竟然是一個免費的企業級 Oracle 資料庫。
這篇文章會從最基礎的 OLAP vs OLTP 概念開始講,分享我的資料儲存進化史,然後帶你認識 ADB 這個「免費仔的終極資料庫方案」。
先搞懂:OLTP vs OLAP 是什麼?
在選資料庫之前,有一個基礎概念一定要先搞清楚。不然就算給你世界上最好的資料庫,用錯方式一樣跑得很慢。
OLTP — 交易處理型
OLTP(Online Transaction Processing) 處理的是「一筆一筆的日常操作」。
想像你在便利商店結帳:掃了一瓶水、一個便當,POS 系統要做的事是——新增一筆訂單、扣掉庫存、更新會員點數。每次操作的資料量很小,但頻率非常高,而且每一筆都不能出錯。
特性:
- 高頻、小量的讀寫操作
- 強調即時性和一致性
- 適合:網站後端、會員系統、訂單系統、API
- 代表資料庫:MySQL、PostgreSQL、Oracle ATP
OLAP — 分析處理型
OLAP(Online Analytical Processing) 處理的是「大量資料的彙總分析」。
想像會計師在做年度財報:他不是在改一筆一筆的帳,而是要掃過去一整年的所有交易紀錄,做加總、分組、比較。資料量巨大,但更新頻率低。
特性:
- 低頻、大量的讀取操作
- 強調查詢速度和聚合效率
- 適合:報表分析、資料倉儲、BI 儀表板
- 代表資料庫:BigQuery、Snowflake、Oracle ADW
為什麼這對你有差?
很多人在選資料庫時根本不會想到這層。結果就是:
- 拿 OLTP 資料庫去跑大量分析查詢 → 慢到懷疑人生
- 拿 OLAP 資料庫去做 API 即時查詢 → 延遲高到爆
而大多數免費資料庫,只能選一邊。
但 ADB 不一樣。它提供兩種 Workload Type——ADW(分析型)和 ATP(交易型)——讓你根據需求選擇,而且免費方案直接給你兩個實例。後面會詳細介紹怎麼選。
常見誤區:「讀資料」不等於 OLAP
很多人會以為:「我的應用程式主要是在讀資料,所以是 OLAP 吧?」——其實不是。
判斷標準不是「讀還是寫」,而是存取模式:
- 網站 API 查「某一檔股票最近 30 天的價格」→ 範圍小、要快、多人同時查 → OLTP
- 分析師跑「過去三年全市場 2000 檔股票的平均溢價率排名」→ 掃整張表、大量聚合 → OLAP
簡單記:小範圍即時查詢 = OLTP,大範圍批次分析 = OLAP。
我的股票資料儲存進化史
在介紹 ADB 之前,先說說我是怎麼一路走到這裡的。這段經歷應該很多做 Side Project 的人都能感同身受。
第一站:CSV — 本地檔案時期
剛開始研究股票資料的時候,最直覺的做法就是把資料存成 CSV。Python 的 pandas 一行 to_csv() 搞定,簡單粗暴。
但問題來得很快——幾百檔股票 × 每日價量資料,資料夾裡很快就塞滿了幾百個 CSV 檔案。想查「過去三個月溢價率低於 5% 的可轉債」?抱歉,你得自己寫迴圈讀檔、手動 filter、然後祈禱檔案格式沒有跑掉。
更別說版本管理了。覺得欄位要調整?改了之後舊檔案全部不相容。
第二站:MySQL — 自架資料庫時期
受不了 CSV 之後,自然而然就想到裝一個「真正的資料庫」。MySQL 免費、文件多、社群大,入門門檻低。
裝在本機之後確實爽了不少——SQL 查詢、JOIN、聚合分析,該有的都有了。
但新的問題出現了:
- 電腦關機 = 資料庫斷線。想跑個每日排程抓資料?你得確保電腦 24 小時開著
- 備份自己來。忘了備份然後硬碟掛掉的恐怖故事,我不想經歷
- 想讓別的服務連進來?得設定防火牆、Port Forwarding,搞半天
花在「維護資料庫」的時間,比花在「分析資料」的時間還多。本末倒置了。
第三站:Google Sheets — 雲端土法煉鋼時期
既然本地資料庫太麻煩,那用雲端的總行了吧?Google Sheets 免費、雲端、有 API、還能協作。用 Apps Script 寫個定時抓資料的腳本,看起來挺像那麼回事的。
一開始確實很爽。直到資料開始變多——
- Sheet 開啟速度越來越慢,幾千列就開始卡了
- 1000 萬格上限,聽起來很多?幾十欄 × 幾千檔股票 × 每日資料,一年就快撞到天花板
- Apps Script 的執行時間限制(6 分鐘)和 API Quota,動不動就撞到限制
- 說到底,Google Sheets 不是資料庫。它是試算表
第四站:OCI ADB — 最終解
在接觸 OCI 之後,我發現 Always Free Tier 裡竟然包含 2 個 Autonomous Database 實例,每個有 20GB 儲存空間。
抱著「反正免費,試試看」的心態開通了一個 ATP 實例。結果一用就回不去了:
- 全託管:不用裝任何東西,開通後直接用
- 自動備份:完全不用操心,Oracle 自動處理
- 標準 SQL:寫慣 MySQL 的人稍微適應一下語法差異就好
- Web 版 SQL 編輯器:Database Actions 內建的 SQL Worksheet,瀏覽器打開就能下 Query
- Python / Node.js SDK:程式連線也很方便
而且最關鍵的——效能完全不是同一個等級。Oracle Database 在 RDBMS 領域的優化做了幾十年,就算是免費的 1 OCPU 實例,跑起來也比我自架的 MySQL 快。
一張表說明一切
| CSV | MySQL | Google Sheets | OCI ADB | |
|---|---|---|---|---|
| 費用 | 免費 | 免費(需自架) | 免費 | 免費 |
| 查詢能力 | 無 | SQL | 有限 | 完整 SQL |
| 雲端存取 | 要自己設定 | |||
| 自動備份 | 要自己做 | 版本紀錄 | 全自動 | |
| 可存資料量 | 看硬碟 | 看硬碟 | 1000 萬格 | 20GB |
| 維運成本 | 低 | 高 | 低 | 極低 |
| 效能 | 無查詢引擎 | 中等 | 極差 | 企業級 |
Autonomous Database 到底有多強(多佛)?
OK,所以 ADB 是我最後選擇的方案。但它到底好在哪?讓我把它的核心優勢拆開來講。
全自動維運
這是 ADB 名字裡「Autonomous(自治)」的由來。傳統的資料庫管理需要 DBA(Database Administrator)來做:
- 效能調校(Index 要不要建?Query Plan 怎麼優化?)
- 安全性更新(Patching)
- 備份與還原策略
- 儲存空間管理
ADB 把這些全部自動化了。你要做的事只有:開通、連線、下 Query。其他的 Oracle 全包了。
用一句話形容:等於請了一個不用付薪水的 DBA。
不是閹割版,是企業級引擎
有些雲端免費資料庫給你的是功能受限的「玩具版」。ADB 不是。
它底層跑的是跟 Oracle 企業客戶一模一樣的 Oracle Database 引擎。你可以用:
- PL/SQL:儲存程序、觸發器、進階邏輯
- Materialized View:物化視圖,複雜查詢預先計算
- Partitioning:大表分區,查詢效能飛起
- JSON 原生支援:同一個資料庫裡可以同時存關聯式資料和 JSON 文件
這些功能在其他免費方案裡幾乎看不到。
Always Free 的佛心規格
| 項目 | 規格 |
|---|---|
| 實例數 | 2 個(可以各選不同 Workload Type) |
| 儲存空間 | 各 20GB |
| CPU | 1 OCPU |
| 記憶體 | ~8GB RAM |
| 內建工具 | Database Actions(Web 版管理介面 + SQL Worksheet) |
以下是我的 ADB 實例資訊頁面,可以看到 Workload Type、Database Version、Instance Type 等基本資訊:
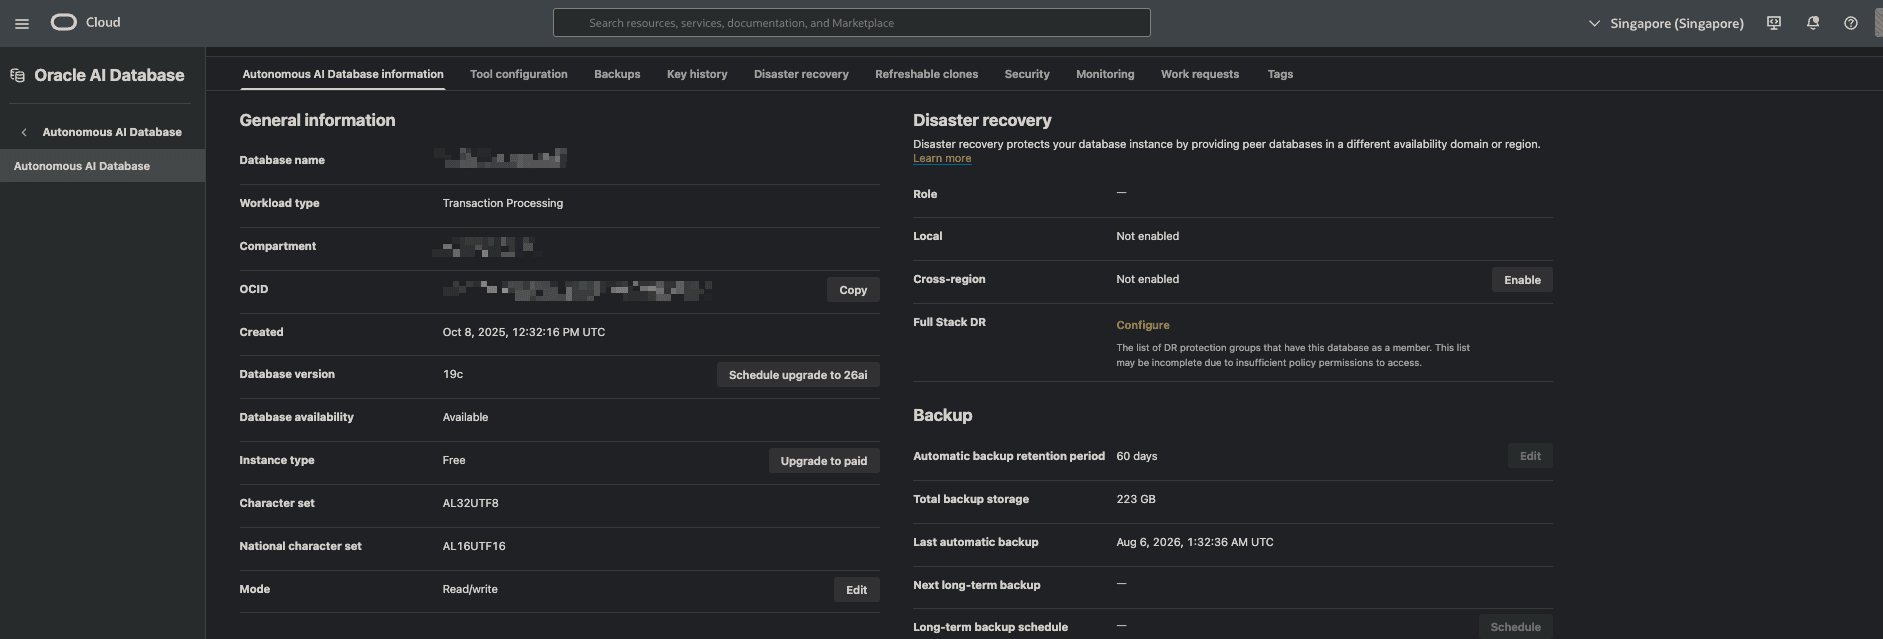 OCI Autonomous Database Console 總覽頁面
別小看 20GB——以我的可轉債實驗室為例,跑了這麼久的股票數據和可轉債歷史資料,目前才用了大約 3.6 GB,不到 20GB 的五分之一。後面會教你怎麼自己估算資料量。
安全性不打折
- TDE(Transparent Data Encryption):資料預設全加密,存在硬碟上的都是密文
- 網路隔離:可以設定 Private Endpoint,只允許你的 VCN 內部存取
- 自動安全 Patching:漏洞修補不用你操心
你的個人 Side Project 資料庫,享受的安全等級跟企業客戶一樣。這在免費方案裡是很罕見的。
ADW vs ATP — 該選哪一種?
ADB 在開通時會問你選 ADW(Autonomous Data Warehouse) 還是 ATP(Autonomous Transaction Processing)。
前面已經講了 OLAP 和 OLTP 的概念,這裡直接對應到 ADB 的選擇:
| ADW (Data Warehouse) | ATP (Transaction Processing) | |
|---|---|---|
| 底層優化 | OLAP — 大量資料掃描、報表分析 | OLTP — 高頻小量讀寫 |
| 索引策略 | 自動建 column-based 索引 | 自動建 row-based 索引 |
| 最適合 | 數據倉儲、BI 分析、海量歷史資料 | 網站後端、API、即時查詢 |
| GCP 對應 | BigQuery | Cloud SQL |
實話說:小資料量兩個都一樣
如果你的資料量不大,選哪個真的都可以。
拿可轉債來說,台灣市場一天新增的可轉債資料大概就幾百筆。就算把所有股票的每日價量都存進去,一年也不過幾十萬筆。這種量級,ADW 和 ATP 跑起來體感完全一樣——底層都是同一個 Oracle Database 引擎,SQL 語法也完全相同。差別只在查詢優化器的策略不同,要到百萬筆以上才會感受到差異。
我的選擇:ATP(老實說是不小心選的)
坦白講,我當初開通 ADB 的時候根本不知道還有 ADW 可以選,就直接建了一個 ATP。
但結果證明,這個「不小心」完全沒有影響。cb lab 網站的 API 需要即時查詢回應,這正好是 ATP 擅長的場景。而且我的資料規模不大,就算當初選了 ADW,體感上也不會有差異。
補充:我用了 OLAP 的 Schema 設計,但選了 ATP
有趣的是,我的底層資料設計其實用了 Star Schema(星型結構)——Fact Table 存每日價量事實資料,Dimension Table 存股票基本資訊、可轉債條件等維度資料。Star Schema 是經典的資料倉儲(OLAP)設計模式。
但因為我的主要存取模式是網站 API 即時查詢,所以選了 ATP。實際跑下來,ATP 對 Star Schema 的查詢效能也完全沒問題——畢竟底層都是同一個 Oracle Database 引擎。Schema 怎麼設計是一回事,選 ADW 還是 ATP 看的是你的存取模式,而不是 Schema 結構。
選擇建議
- 不確定選什麼? → 選 ATP。通用性更高,OLTP 場景和中小規模的分析都能處理
- 純分析、跑報表、不做 API? → 選 ADW。對聚合查詢(SUM、GROUP BY、大範圍掃描)有額外優化
- 記住:免費方案給你 2 個實例。以後覺得需要,隨時可以再開一個試試
20GB 到底夠不夠用?
很多人看到「20GB」會覺得好像不太多。但對大多數 Side Project 來說,20GB 是非常充裕的。
直接用我的實際數據來說話:
可轉債實驗室存了過去五年的所有股票歷史資料、可轉債數據、以及各種 Log 和中繼表,目前總共佔 約 3.6 GB——不到 20GB 的五分之一。
這 3.6 GB 的資料產生了什麼價值?
就是這些存在 ADB 的資料,支撐起了 cb lab 的 最新可轉債列表 與 技術分析頁面。不需要龐大昂貴的伺服器,只要一台免費的 ATP,就能讓網站快速呈現全市場的數據。
換算下來,平均一年大約 720 MB。照這個速度,20GB 還可以再存超過 20 年的資料。
用 SQL 查看實際用量
如果你已經在用 ADB,可以用這個 SQL 查看目前的儲存用量:
SELECT ROUND(SUM(bytes) / 1024 / 1024, 2) AS total_mb
FROM user_segments;
建議定期查一下,心裡有個底。不過以個人專案的規模來說,20GB 基本上不太可能用完。
我的 ADB 實際畫面
光說不練假把式,讓你看看 ADB 實際操作起來長什麼樣。
Database Actions — SQL Worksheet
ADB 內建的 Web 版 SQL 編輯器,不用裝任何軟體,瀏覽器打開就能寫 SQL。支援自動補全、執行計畫查看、結果匯出。對不想裝 IDE 的人來說,這個工具非常夠用。
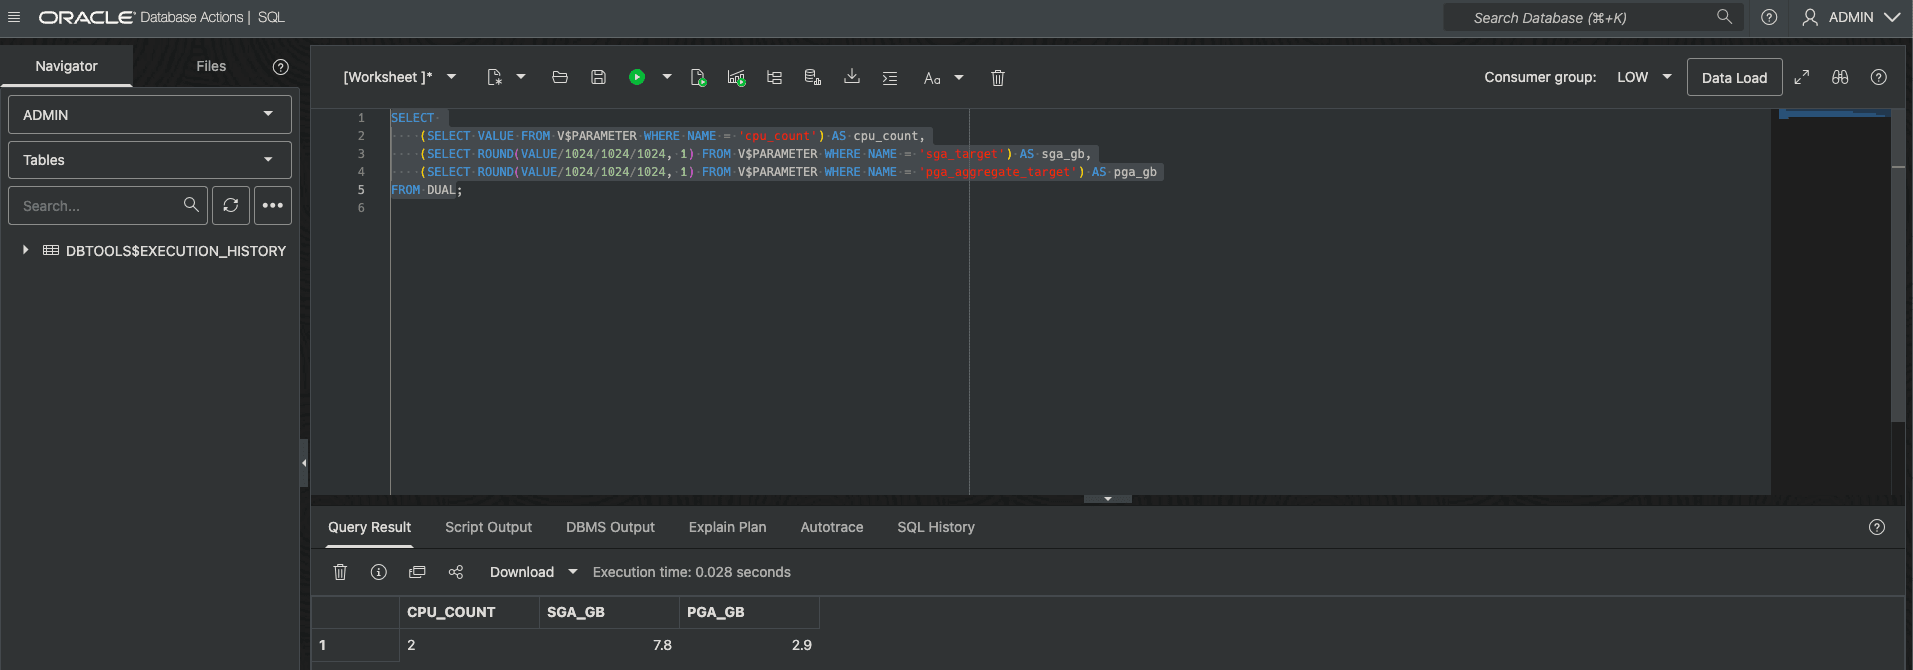 Database Actions SQL Worksheet — 瀏覽器直接寫 SQL 查詢
Monitoring 儀表板
ADB 的監控畫面可以看到 CPU 使用率、儲存用量、連線數等關鍵指標。Free Tier 的監控功能跟付費版是一樣的,讓你隨時掌握資料庫的健康狀態。
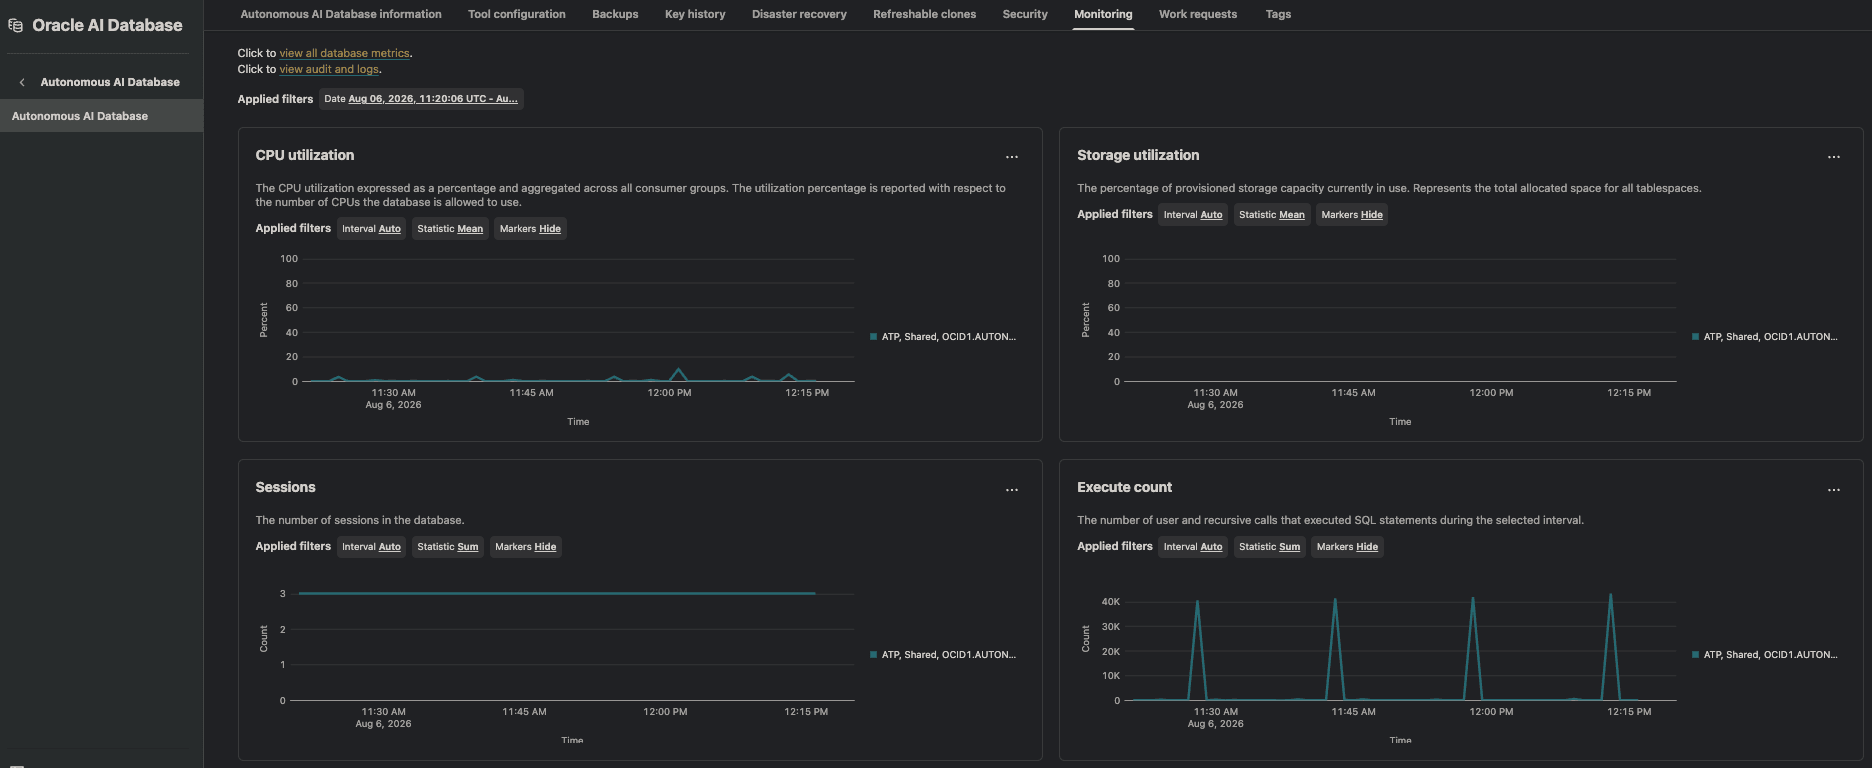 ADB Monitoring 儀表板 — CPU、Storage、Sessions、Execute Count 即時監控
踩過的雷 & 新手要注意的事
ADB 雖然很好用,但還是有一些坑。以下是我實際遇到的,先幫你踩過。
連線方式:直接用 TLS
早期 ADB 連線需要下載一個叫做「Wallet」的檔案包,設定相當麻煩。好消息是——Oracle 現在已將 TLS 設為預設連線方式,不再需要下載 Wallet,設定簡化很多。
程式端的連線也變簡單了:
- Python:用
python-oracledb的 thin mode,不需要安裝 Oracle Client - Node.js:用
oracledbpackage 的 thin mode,一樣免裝 Client
Thin mode 是關鍵字——它代表純程式語言實作,不依賴 Oracle 的原生 C Library。安裝和部署都輕量很多。
Always Free 的限制
免費方案再好,也有它的限制。你需要知道:
- 不能 Scale Up:鎖定在 1 OCPU / 8GB RAM,不能往上調。但說實話,對個人專案來說完全夠用
- 閒置 7 天會自動停止:如果你的 ADB 連續 7 天沒有任何連線或操作,Oracle 會自動把它停下來(不是刪除,資料還在)。需要手動到 Console 重新啟動
- 我的做法:因為 cb lab 每天都有 OCI Functions 跑 ETL 排程抓股票資料,自然不會觸發閒置停止。如果你沒有每日排程,可以寫一個簡單的 cron job 定期 ping 一下資料庫
SQL 語法差異
如果你是從 MySQL、PostgreSQL 或 Snowflake 過來的,有幾個常見的語法差異需要注意:
| 其他資料庫 | Oracle (ADB) |
|---|---|
LIMIT 10 | FETCH FIRST 10 ROWS ONLY |
NOW() / CURRENT_TIMESTAMP() | CURRENT_TIMESTAMP 或 SYSDATE |
IF(cond, a, b) / IFF(cond, a, b) | CASE WHEN cond THEN a ELSE b END |
AUTO_INCREMENT / AUTOINCREMENT | GENERATED ALWAYS AS IDENTITY |
SHOW TABLES | SELECT table_name FROM user_tables |
不用太擔心——基本的 SELECT、INSERT、JOIN、GROUP BY 語法是完全通用的。進階語法查一下文件就好,而且現在有 AI 輔助,語法轉換幾秒鐘的事。
其他小提醒
- 時區:ADB 預設時區是 UTC,如果你存的是台灣時間的資料,記得在查詢時做轉換
- 大小寫:Oracle 的表名和欄位名預設會轉成大寫。如果你習慣小寫命名,建議用雙引號包起來(如
"my_table"),或者直接接受大寫 - 連線字串:開通 ADB 後,在 Console 的「DB Connection」按鈕可以直接複製連線字串,非常方便
下一篇預告
這篇介紹了 ADB 的核心概念和實際使用經驗。但資料庫只是基礎設施——資料要怎麼「自動」跑進資料庫裡?
下一篇文章,我會分享如何用 OCI Functions(Serverless) 搭配 FinMind 開源資料源,打造一個全自動的股票資料 ETL Pipeline。每天定時抓資料、清洗、寫入 ADB,完全不需要維護伺服器,而且全部免費。
想了解更多?
如果您對我們的技術架構感興趣,歡迎查看 系統架構頁面,了解可轉債實驗室背後的 Data Pipeline 與即時監控系統。
也歡迎加入我們的 Telegram 頻道,免費獲取每日策略資料通知。